30 秒看結論
- 牌價一樣、能力相當,成本仍可能差很多,GPT-6 Astra 與 Claude Fable 5.1 每題費用差 8.7 倍。
- 牌價便宜不等於省,牌價便宜一半的模型,每題成本可能高出 5.5 倍。
- 要知道自己的成本,得用自己的工作實測,比較多家模型,需要逐家串接。
- 勤英科技的 MixRoute:一組 API key 串接多家模型,在同一個後台查看各家費用,輕鬆比較成本。
牌價一樣、能力相當,每件任務的成本會一樣嗎?
不一定。牌價只是每單位 token 的價格,實際費用還要看模型完成工作時消耗多少 token。
數學評測平台 MathArena 每個月以新公布的題目出一批考題讓多款模型作答,每題執行 4 次,記錄正確率與作答一題平均的實際 API 費用。
在 2026 年 6 月那批題目上,GPT-6 Astra 與 Claude Fable 5.1 的牌價相同。兩款模型的正確率分別為 94.4% 與 91.0%。
兩款每題平均 API 費用分別為 $0.67 與 $5.86,相差 8.7 倍。
同一組模型,4 到 6 月三批題目都差 8.7 到 11.6 倍
這個差距不是單一場的結果。兩款模型維持相同設定,作答 4 到 6 月三批題目的表現如下:
| 題目月份 | Astra 正確率 | Astra 每題成本 | Fable 5.1 正確率 | Fable 5.1 每題成本 | 成本相差 |
|---|---|---|---|---|---|
| 2026 年 4 月 | 90.8% | $0.59 | 77.5% | $6.87 | 11.6 倍 |
| 2026 年 5 月 | 95.0% | $0.57 | 87.5% | $5.38 | 9.4 倍 |
| 2026 年 6 月 | 94.4% | $0.67 | 91.0% | $5.86 | 8.7 倍 |
正確率相近的模型,每題成本可以差多少?
正確率相近的模型,每題成本可以相差數十倍。
下表從 6 月場的 25 款模型中,挑出官方定價頁查得到標準牌價的主力模型,以及本文拿來對照的設定;25 款的完整名次見表後的原始截圖。
表中的費用是這批數學題目的實測結果,可用來觀察成本差距;企業選型仍須以自己的工作案例另測。
| 名次 | 模型(推理強度) | 正確率(信賴區間) | 每題成本 | 平均輸出 token | 牌價(每百萬 token,輸入/輸出) |
|---|---|---|---|---|---|
| 1 | GPT-6 Astra(max) | 94.4%(±3.7) | $0.67 | 12,636 | $10/$50 |
| 2 | Claude Fable 5.1(max) | 91.0%(±4.7) | $5.86 | 117,076 | $10/$50 |
| 4 | Claude Fable 5(max) | 85.4%(±5.8) | $3.79 | 75,675 | $10/$50 |
| 5 | GPT-6 Astra(low) | 84.4%(±7.3) | $0.088 | 1,711 | $10/$50 |
| 7 | Claude Opus 5(max) | 82.6%(±6.2) | $3.66 | 146,509 | $5/$25 |
| 9 | Qwen3.8-Max | 75.7%(±7.0) | $0.39 | 64,770 | $2/$6 |
| 12 | Gemini 3.8 Flash | 67.4%(±7.7) | $0.15 | 40,222 | $0.75/$3.75 |
| 15 | Gemini 3.7 Flash | 62.5%(±7.9) | $0.084 | 22,313 | $0.75/$3.75 |
| 22 | Claude Fable 5.1(low) | 38.5%(±9.7) | $0.11 | 2,140 | $10/$50 |
牌價為各家定價頁的標準價(2026 年 9 月 23 日查閱),Qwen3.8-Max 為阿里雲國際部署的價格。原始排名圖中的 ⚠️ 標記,見下方說明。
若把正確率與每題平均費用一起看,GPT-6 Astra(low)與 Claude Opus 5(max)這組尤其明顯:在這批題目上,兩款的正確率信賴區間重疊,但每題平均費用相差 42 倍。
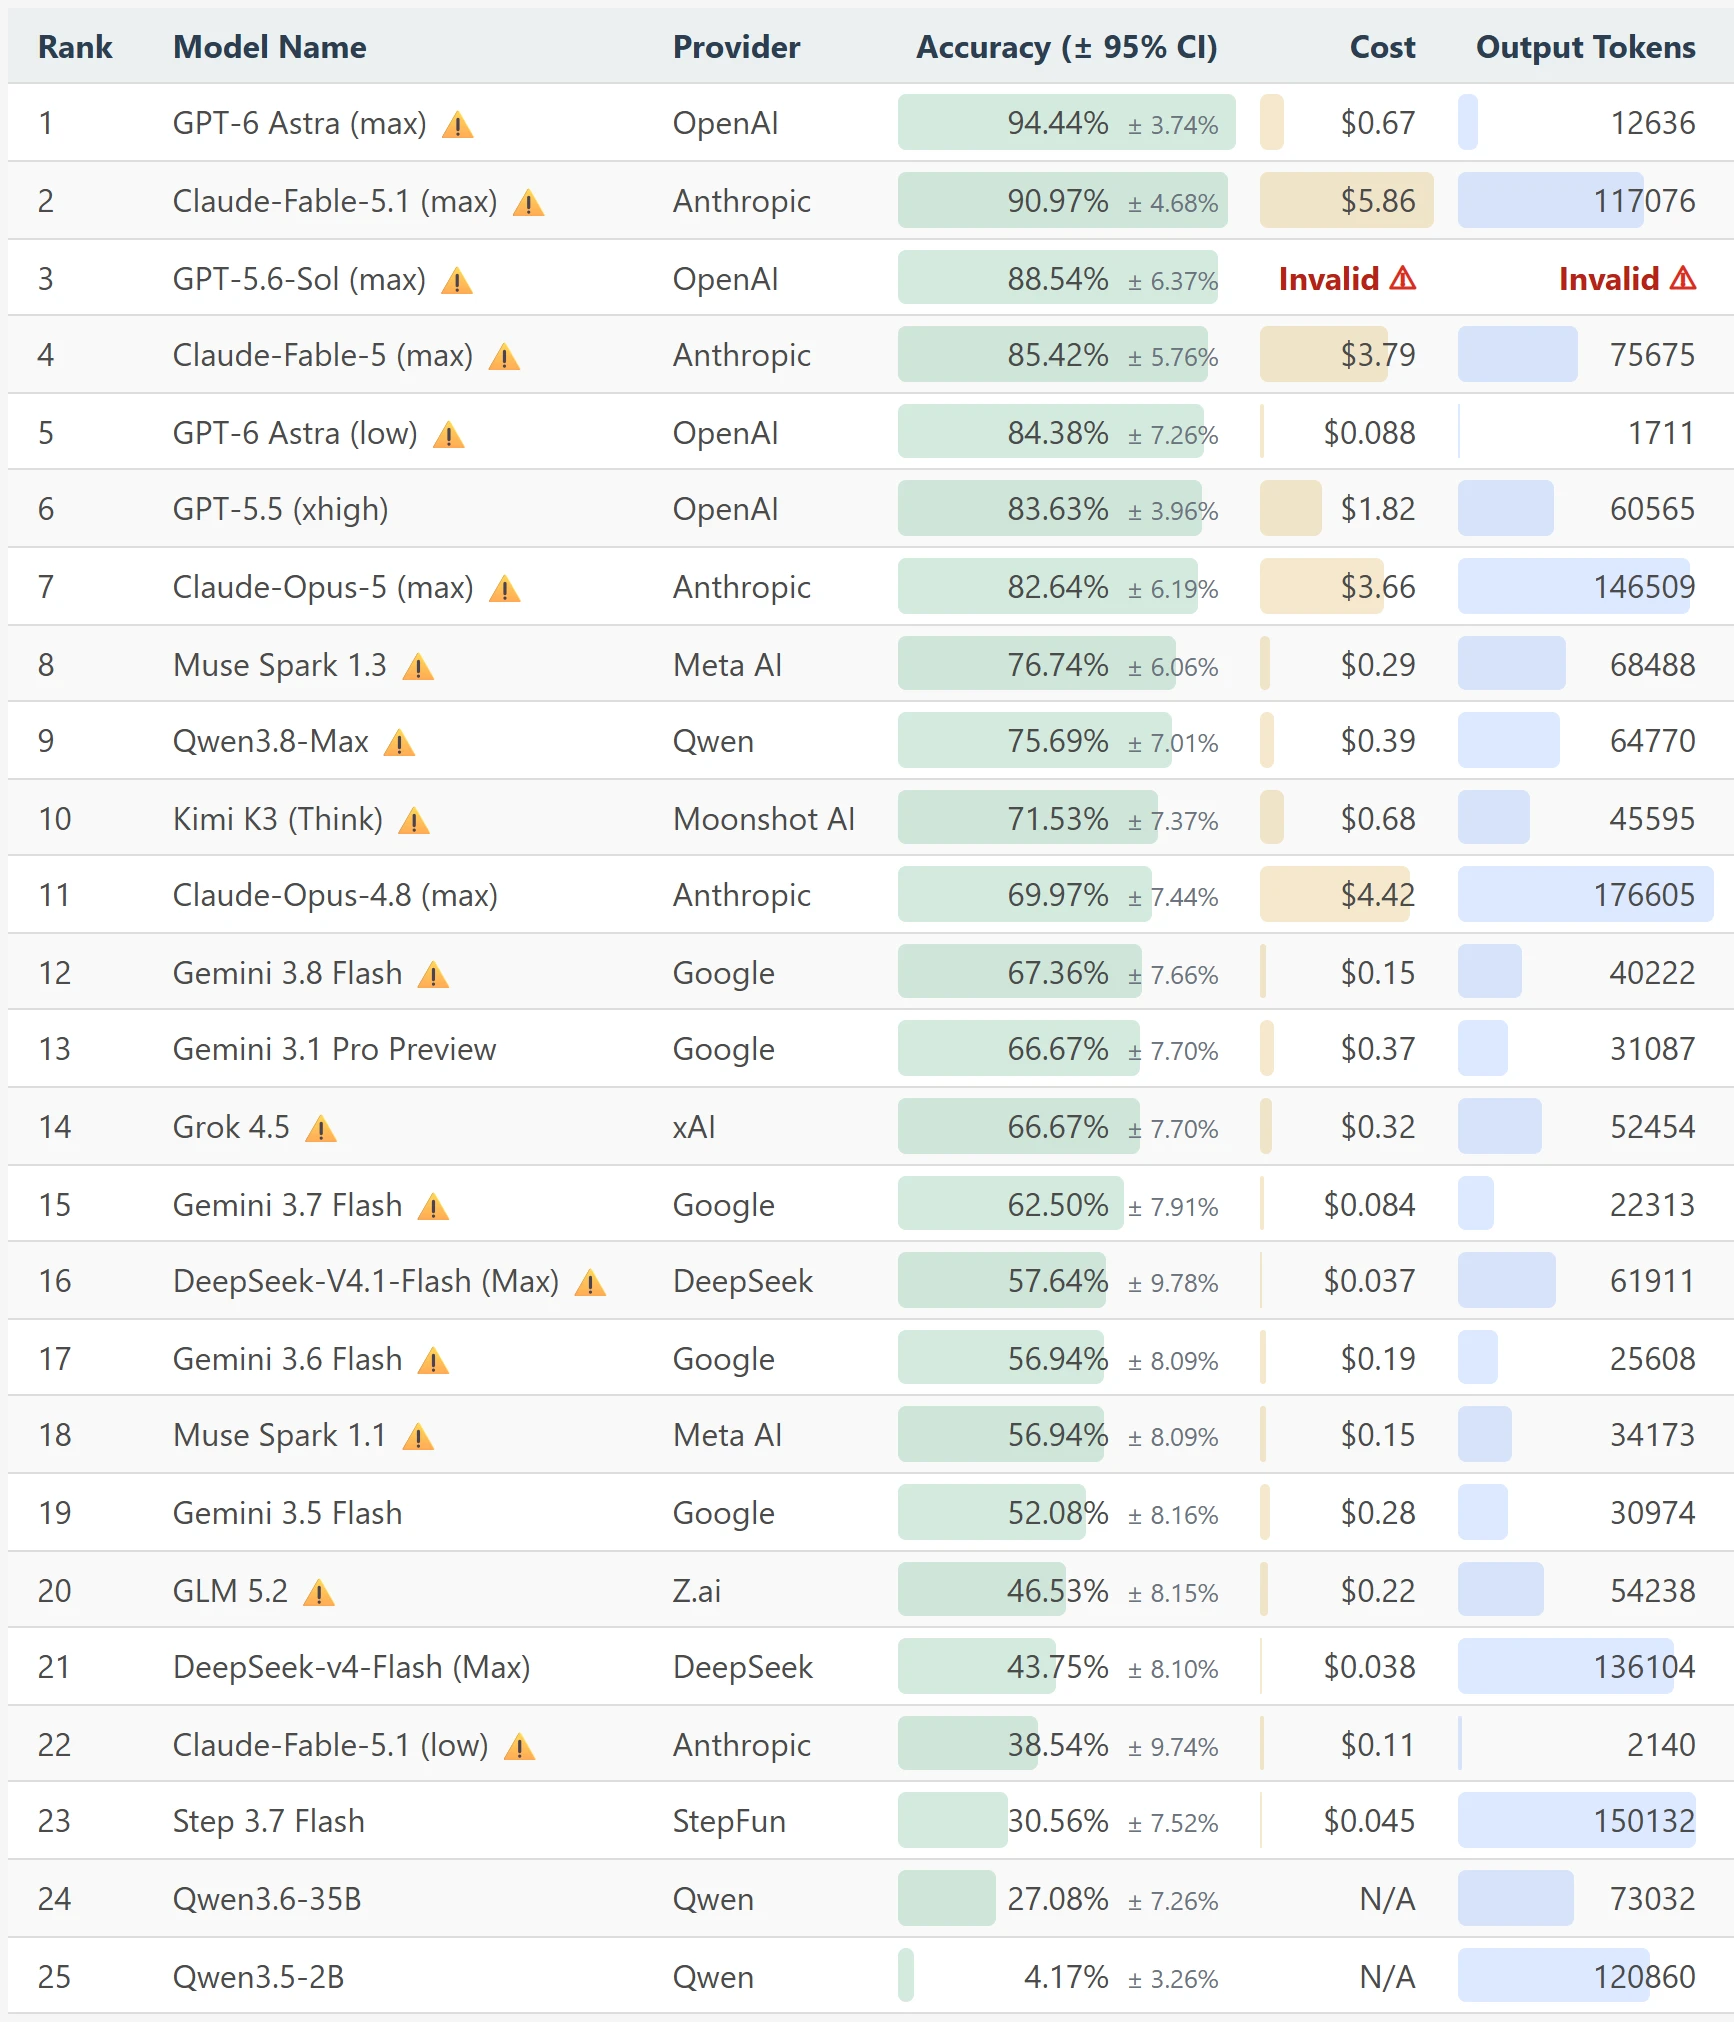
原始排名圖中三種標記的意思:
- ±:95% 信賴區間。本文將區間重疊的模型視為正確率相近。
- ⚠️:模型在這批題目公布後才發表,訓練時可能已接觸過這批題目,正確率宜保守解讀;每題成本與 token 用量仍是實際測得的數字。
- Invalid:GPT-5.6-Sol 的成本欄。OpenAI 回報的單次用量異常,MathArena 判定相關成本無效。
成本差在哪?牌價之外,還要看用量
完成一題消耗多少 token,決定帳單
牌價相同時,每題成本的差距全部來自用量。前表牌價同為 $10/$50 的幾個設定,平均輸出 token 的差距,幾乎就是每題成本的差距。
定價頁只列出每百萬 token 的單價,不會告訴你模型完成一件工作需要多少 token。
牌價怎麼讀、輸入與輸出怎麼分開計算,見〈OpenAI API 費用怎麼算?2026 計費與成本一次看〉。
牌價便宜一半,每題成本反而高 5.5 倍
牌價排不出每題成本的高低。Claude Opus 5 的牌價是 GPT-6 Astra 的一半,6 月場的每題成本卻是 Astra 的 5.5 倍,正確率也較低。
選定模型之後,如何分層使用與控制成本,見〈AI API 成本怎麼省?LLM API 成本優化的 4 層策略〉。
MathArena 的每題費用不能直接當作企業工作的預算。要知道自己的成本,得讓候選模型處理同一批實際案例,再把費用與驗收結果放在一起看。
比較多家模型的實際費用,一定要逐家串接嗎?
不必逐家串接,可以透過 AI Gateway 從同一個入口使用多家模型。
若直接使用各家的 API,每多一家供應商,就要多申請一組金鑰、多完成一次串接、多處理一份付款與帳單;比較費用時,還得自行彙整各家的用量。
勤英科技自行開發的 MixRoute 是一套 AI Gateway,提供以下功能:
- 一組 API key 串接多家模型:使用 MixRoute 支援的模型時,不必逐家申請金鑰與完成串接。請求格式相容 OpenAI API,方便在同一套測試流程中切換候選模型。
- 新模型通常在 24 小時內接入:平台接入後,即可沿用既有串接,以同一批工作測試新模型,減少重新準備的時間。
- 在同一個後台查看用量與費用:各款模型消耗多少 token、花了多少錢,可以集中查閱,不必再逐家核對帳單。將測試費用與驗收結果彙整後,就能比較每件合格成果的 API 成本。
如果還不確定哪些工作適合測試、該比較哪幾款模型,勤英科技的企業 AI 導入評估可以協助從現有流程挑選測試案例、訂定驗收標準,並規劃候選名單。
結論:用每件合格成果的成本選模型
牌價一樣、能力相當的模型,完成同一件工作的成本仍可能差好幾倍。
選模型前,先拿一批實際工作讓候選模型各做一遍,再比較合格成果的費用;從挑選工作到多家模型的串接,勤英科技都可以協助。
資料來源
- MathArena:ArXivMath 2026 年 6 月場排名與方法說明(首頁選 ArXivMath 與 06/2026;每題各執行 4 次,成本為實際 API 費用,± 為 95% 信賴區間;查閱 2026 年 9 月 23 日)
- MathArena:GPT-6 Astra (max) 模型頁(4 至 6 月三場的數字;查閱 2026 年 9 月 23 日)
- MathArena:Claude Fable 5.1 (max) 模型頁(4 至 6 月三場的數字;查閱 2026 年 9 月 23 日)
- Anthropic 定價頁(查閱 2026 年 9 月 23 日)
- OpenAI API 定價頁(查閱 2026 年 9 月 23 日)
- Gemini API 定價頁(查閱 2026 年 9 月 23 日)
- 阿里雲 Model Studio 定價頁(查閱 2026 年 9 月 23 日)