
企業的 AI 應用從概念驗證進入正式環境後,常會出現一個落差:使用量持續增加,API 帳單成長得更快,但生意沒有跟著長。
問題不一定是 Token 用得太多,也可能是所有請求都走同一個模型,不分難易。
「你們幾點關門?」和「幫我重構整個交易模組」,難度明顯不同,許多企業的 AI 應用卻會把兩者送進同一個旗艦模型。原因很簡單:模型通常在系統上線時選定,之後所有流量都沿用同一套設定。為了確保最困難的任務能完成,團隊最後往往用最高規格承接全部需求。
智慧路由要處理的正是這種結構性浪費。它不會改變模型供應商公布的 Token 單價,而是依每一筆的任務與難度挑模型,把平均每筆的花費和整體 API 支出一起壓下來。
30 秒看結論
- 帳單變高不一定是用量問題,也可能是所有任務都在使用同一個高價模型。
- 智慧路由讓簡單任務走輕量模型,困難任務才動用旗艦模型,降成本但不必全面降級。
- 要確認值不值得,用自己的流量切一小部分試行,對照成本、品質與延遲再決定擴大。
三種場景,看看你的錢花在哪裡
這種浪費不容易從總帳單看出來。財務部門看到的是 API 支出持續增加,技術團隊看到的是服務仍然正常,沒有人能直接回答其中有多少費用花在不需要旗艦模型的任務上。
- 客服機器人:大部分是查訂單狀態、問退貨規則,少數才是需要判斷的疑難案件,但每一題都以同一個高階模型回答。
- 內部知識助理:員工查一條差旅規定,和法務分析一份三年期合約的風險,共用同一個模型。
- 程式開發助手:補完一段函式,和跨十幾個檔案重構,也是同一個模型在承接。
這三種的共同點是:為了少數幾題真正難的,其他每一題也跟著付最貴模型的價錢。
人工任務分層可以先解決一部分,例如摘要固定使用輕量模型、複雜生成使用高階模型,完整方法我們整理在 AI API 成本怎麼省?LLM API 成本優化的 4 層策略。差別在於人工分層的單位是「功能」,智慧路由則細到「每一筆請求」。
智慧路由怎麼讓簡單的問題別再用最貴的模型
模型路由是在請求送出前,先判斷任務類型與複雜度,再把這一筆分派給適合的模型。做法有三層:
- 簡單、重複、容錯空間較高的任務,交給成本較低的輕量模型。
- 需要多步推理、專業判斷或高準確度的任務,才升級到能力較強的模型。
- 對延遲或風險極度敏感的端點,可以維持直連指定模型,不必全部納入路由。
全面換成便宜模型是另一件事,那會讓最困難的任務直接承擔品質風險。智慧路由要做的是把昂貴模型留給真正需要它的請求。
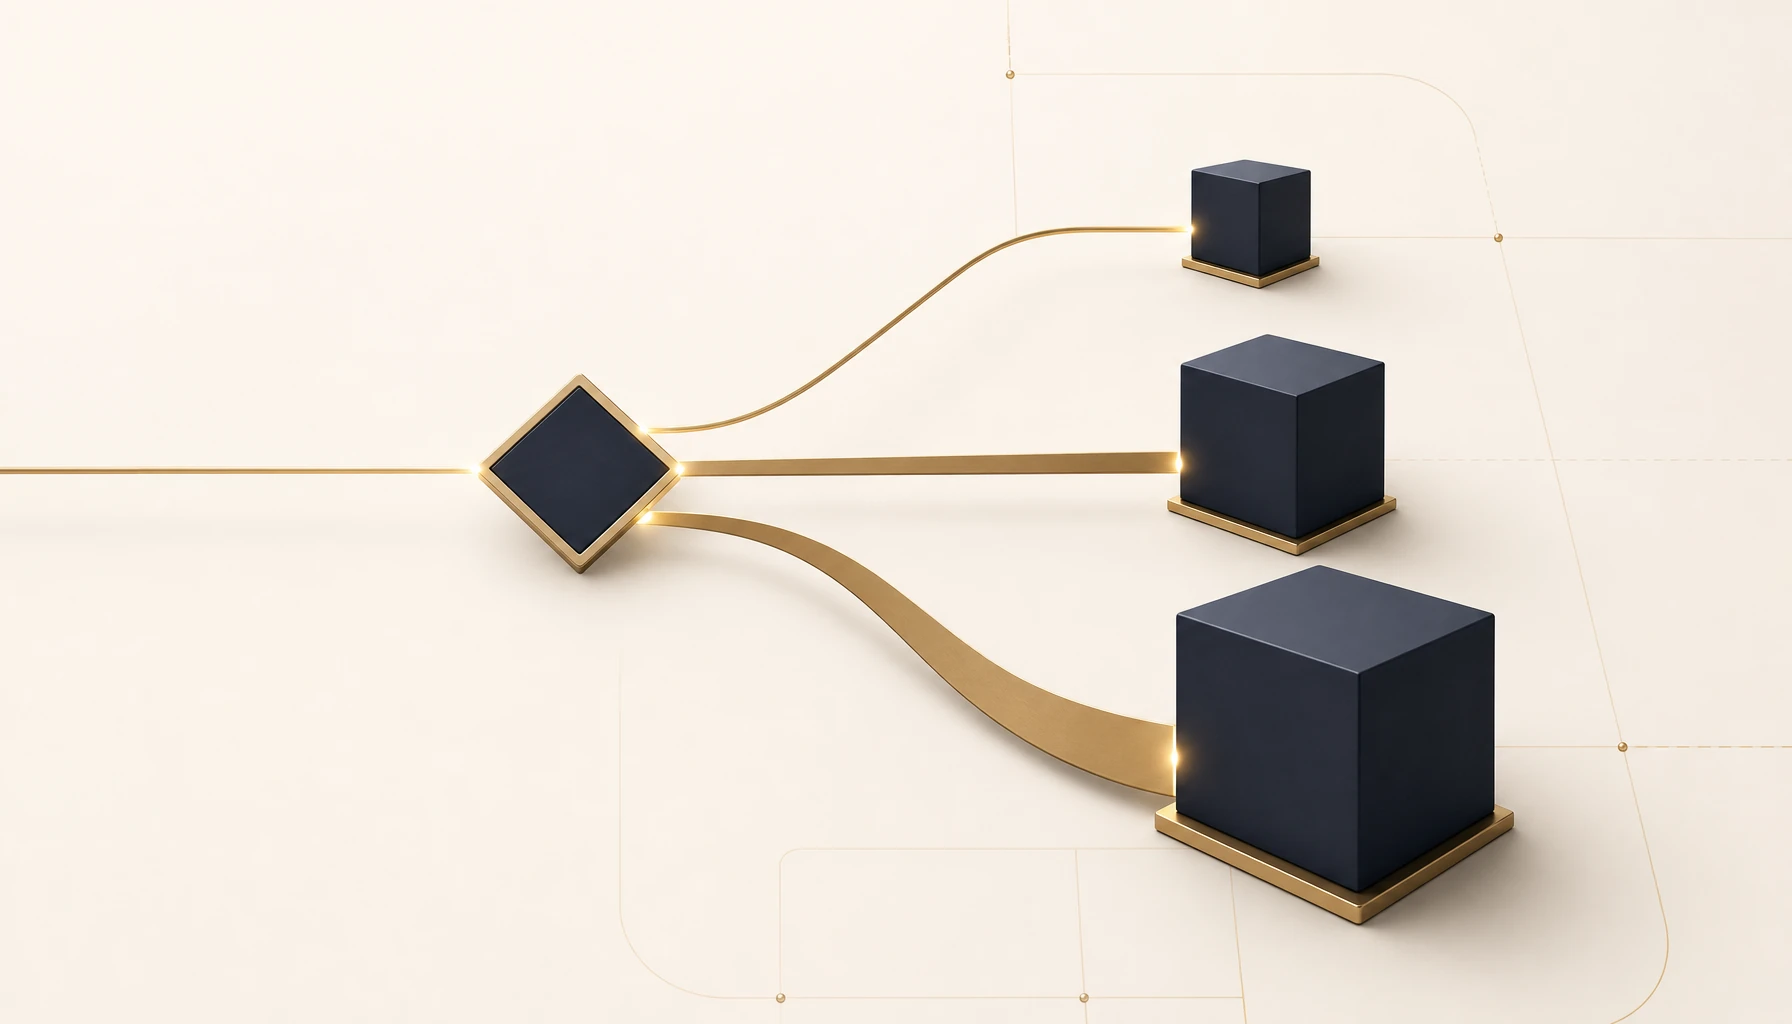
AI Gateway 負責把多家模型供應商的連線、金鑰、用量與備援集中管理,模型路由則負責決定每一筆請求該交給誰。兩者經常整合在同一個平台,職責卻是分開的,需要先了解 AI Gateway 可以參考 AI Gateway 是什麼?多模型路由、備援與成本優化。
三種做法:自建、開源套件、Gateway 內建
真正要比的是要投入多少時間與人力,才能拿到一個能拿去說服人的數字。
| 做法 | 上線速度與內部投入 | 什麼情況選它 |
|---|---|---|
| 自建規則 | 中,但規則會隨新任務型態持續膨脹 | 場景固定、請求型態變化不大的服務 |
| 開源路由套件 | 慢,需要部署、評測、監控與維運能力 | 把模型調度當成核心競爭力,且已有 ML 工程團隊 |
| Gateway 內建路由 | 快,串接與維護負擔較低 | 想先用真實流量驗證省下多少,再決定要不要擴大 |
如果現階段要回答的是「這件事值不值得投資」,先用託管方式量出真實數字,通常比直接成立一個自建專案更快。
MixRoute 的智慧路由
MixRoute 是勤英科技自行開發的 AI Gateway。智慧路由會先判斷每個請求的任務類型與難度,再從企業指定的模型池中分派:簡單任務交給成本較低的模型,真正困難的任務才動用旗艦模型。
- 成本看得到:以超過一萬筆實際任務實測,平均節省 20% 到 40% 的 API 成本,實際幅度依模型池組合而異。智慧路由全面免費,不另收路由服務費,只按實際選用模型的用量計費;控制台內建節省儀表板,省下多少直接看數字。
- 導入負擔低:既有應用只要是 OpenAI 相容格式,換上一組啟用智慧路由的 API Key,並把 model 欄位改成 auto;尚未接上的應用再把 base URL 改指過來,請求格式不必重寫。
- 邊界由企業決定:模型池要放哪些模型、每一組金鑰的用量上限由企業設定,超出即擋,路由不會選用模型池以外的端點。判讀內容只在記憶體中即時處理,完成後立即清除。
結論:三步驟開始驗證
- 選一個成本高、任務難度差異大的服務,先記下目前的花費、延遲與品質表現。
- 切一小部分流量啟用智慧路由,原本的模型留著當對照組。
- 對照成本、品質與延遲,確認有效再擴大範圍。
這件事的判斷其實只卡在一個數字:你現在有多少比例的請求,根本用不到旗艦模型。這個數字量出來,要不要導入通常就很清楚了,而且量它不需要先做任何架構決定。
如果你正在評估企業 AI API 的成本結構,勤英科技可以協助盤點現有流量、找出過度配置的環節。
常見問題
路由會不會讓回答品質變差?
有可能,所以不建議一次全量切換。先切一部分流量與原本模型對照,同時觀察任務完成率、使用者重問率、轉人工率與人工抽查結果,品質仍在企業設定的範圍內,才逐步擴大。
如果路由判斷錯了怎麼辦?可以強制指定模型嗎?
可以。模型池會限制路由只在企業授權的模型之間選擇,不會選用模型池外的其他模型。如果某些流量必須固定使用某一個模型,為它另建一組不啟用智慧路由的一般 Key 直連即可,不必為了導入路由改動整條服務。
會不會增加延遲?
會。判讀是多出來的一道程序,耗時隨請求長度而異,本質上是拿一點時間換成本。內部查詢、批次摘要多這一段,使用者較不會察覺;即時語音、交易決策這種對延遲較敏感的端點,就用一般 Key 直連指定模型,不必納入路由。
判讀模型會讀到請求內容嗎?
會,判讀必須讀取請求,所以評估時要看清楚內容是否留存、在哪裡處理、日誌保留多久。MixRoute 的判讀只在記憶體中即時處理,完成後立即清除。模型供應商本身的資料政策,可延伸閱讀 OpenAI API 資料會被訓練嗎?企業資料隱私與合規完整解析。